ต้นทุนแฝงของ AI ที่หลายองค์กรมองข้าม: บิลสตอเรจจากงาน inference
บทความชี้ว่าเมื่อองค์กรพูดถึงต้นทุนของ AI ภาพที่มักนึกถึงคือ GPU, พลังงานไฟฟ้า และการลงทุนฝั่งคอมพิวต์ แต่ความจริงแล้ว “สตอเรจ” กลายเป็นค่าใช้จ่ายก้อนใหญ่ที่ถูกมองข้ามบ่อยครั้ง โดยเฉพาะในยุคที่การใช้…
บทความชี้ว่าเมื่อองค์กรพูดถึงต้นทุนของ AI ภาพที่มักนึกถึงคือ GPU, พลังงานไฟฟ้า และการลงทุนฝั่งคอมพิวต์ แต่ความจริงแล้ว “สตอเรจ” กลายเป็นค่าใช้จ่ายก้อนใหญ่ที่ถูกมองข้ามบ่อยครั้ง โดยเฉพาะในยุคที่การใช้งาน AI แบบ inference เดินหน้าอย่างต่อเนื่องทุกครั้งที่มีคำสั่งจากผู้ใช้ ไม่ได้จบลงเหมือนการเทรนโมเดลที่เป็นงานเป็นรอบและวางงบได้ชัดเจน
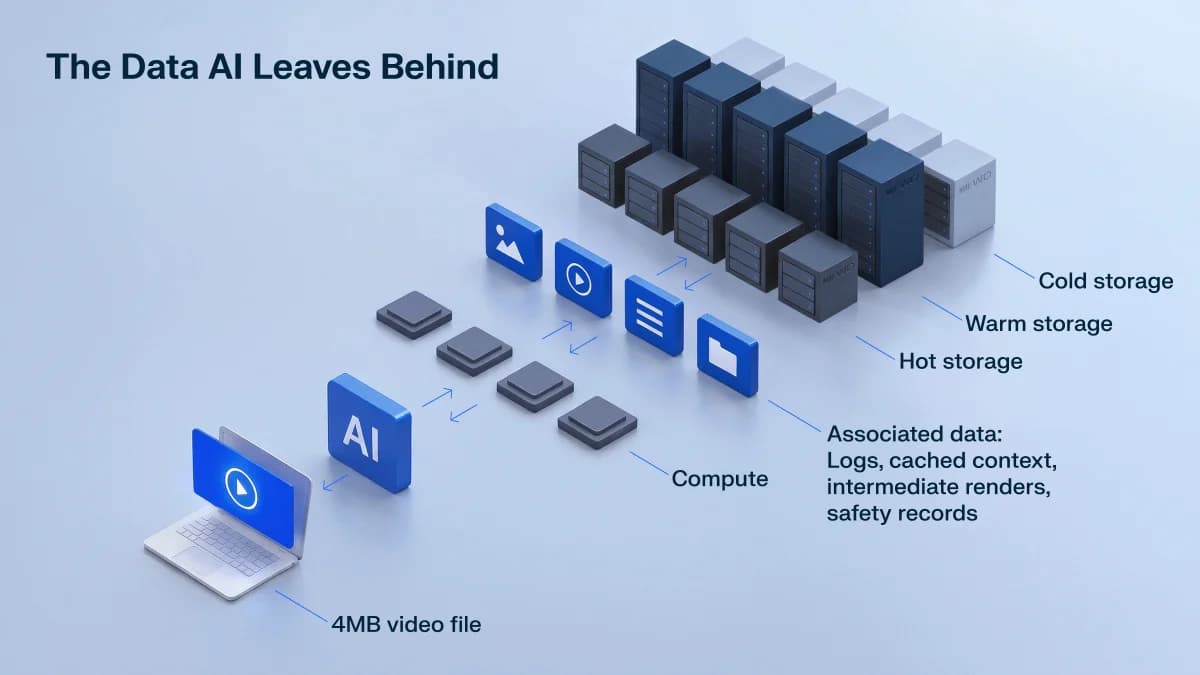
สาระสำคัญของบทความคือ ทุกการตอบสนองของโมเดลไม่ได้ทิ้งไว้แค่ผลลัพธ์ที่ผู้ใช้เห็น แต่ยังสร้างข้อมูลเบื้องหลังจำนวนมาก เช่น logs, context, cache, เวอร์ชันของผลลัพธ์, ไฟล์สำรอง และบันทึกด้านความปลอดภัย ซึ่งต้องถูกจัดเก็บต่อเนื่อง และข้อมูลเหล่านี้เติบโตเร็วตามปริมาณการใช้งานจริง ยิ่งงาน AI ขยายตัวมากเท่าไร ภาระด้านสตอเรจก็ยิ่งสะสมมากขึ้นเท่านั้น
บทความยกตัวอย่างงานสร้างวิดีโอด้วย AI ว่าคลิปขนาดเล็กที่ผู้ใช้ได้รับอาจมีไฟล์เพียงไม่กี่เมกะไบต์ แต่เบื้องหลังกลับทิ้งข้อมูลจำนวนมหาศาลระดับหลายร้อยเมกะไบต์ต่อหนึ่งงาน เมื่อขยายไปสู่ระดับองค์กรที่สร้างคอนเทนต์ความละเอียดสูงหรือความยาวมาก ต้นทุนฝั่งหลังบ้านอาจพุ่งขึ้นเป็นหลักร้อยกิกะไบต์ต่อคลิปได้ง่าย ๆ จึงไม่ใช่แค่ปัญหาพื้นที่ แต่เป็นปัญหาเชิงเศรษฐศาสตร์ของโครงสร้างพื้นฐานทั้งหมด
อีกประเด็นที่บทความเน้นคือแนวโน้มการเติบโตของ AI inference จะเร็วกว่าฝั่ง training ในระยะยาว และมีแนวโน้มกินสัดส่วนสำคัญของความต้องการดาต้าเซ็นเตอร์ภายในไม่กี่ปีข้างหน้า ผลสำรวจที่อ้างถึงยังสะท้อนว่าเกือบทั้งหมดของผู้ตอบแบบสอบถามเห็นปริมาณข้อมูลเพิ่มขึ้นจาก generative AI ในช่วง 12 เดือนที่ผ่านมา โดยหลายองค์กรเจอกับการเติบโตของข้อมูลระดับมากกว่าหนึ่งในสี่ของฐานเดิม นั่นแปลว่าค่าใช้จ่ายด้านสตอเรจอาจโตเร็วกว่างบคอมพิวต์ที่ผู้บริหารโฟกัสอยู่
บทความยังอธิบายว่าการเก็บข้อมูลไม่ได้เป็นเพียงการเก็บสำรองเพื่อย้อนกลับมาใช้งานเท่านั้น แต่ข้อมูลที่สะสมไว้เริ่มกลายเป็นวัตถุดิบสำหรับงาน AI รุ่นถัดไป เช่น retrieval-augmented generation หรือ RAG ทำให้สตอเรจต้องรองรับทั้ง “ปริมาณ” และ “ความเร็วในการเข้าถึง” ไม่ใช่แค่ความจุอย่างเดียว องค์กรจำนวนมากจึงต้องการการดึงข้อมูลจากคลังเก็บถาวรให้เร็วขึ้น เพื่อให้สอดรับกับเวิร์กโหลด AI ที่ต้องเรียกใช้ข้อมูลย้อนหลังบ่อยขึ้น
ในเชิงงบประมาณ บทความเตือนว่า CFO และ CIO มักจัดกรอบ “AI infrastructure” แคบเกินไป โดยมองเฉพาะค่า compute ที่คำนวณได้เป็นรอบ ๆ แต่ละเลยต้นทุนสะสมของ storage ที่เพิ่มตามอายุการใช้งานของข้อมูล และเมื่อระบบเริ่มช้าลงเพราะข้อมูลเรียกใช้ไม่ทัน ก็ยิ่งกลายเป็นต้นทุนแฝงจาก GPU ที่รอข้อมูลโดยเปล่าประโยชน์ สุดท้ายสตอเรจที่ดูเหมือนเป็นค่าใช้จ่ายรองอาจกลายเป็นสัดส่วนสำคัญของโปรแกรม AI ภายใน 12-18 เดือน
ข้อเสนอหลักของบทความคือ องค์กรควรวางสถาปัตยกรรมสตอเรจให้เหมาะกับวงจรชีวิตข้อมูล AI ทั้งหมด ตั้งแต่ hot tier ไปจนถึง warm, cool และ cold tier โดยพิจารณาความจุ ความหนาแน่น ความน่าเชื่อถือ พลังงาน และต้นทุนรวมตลอดอายุการใช้งาน โซลูชันอย่าง HDD ยังมีบทบาทสำคัญในฐานะชั้นข้อมูลปริมาณมากที่คุ้มค่า โดยเฉพาะเมื่อข้อมูลเก่ากลายเป็นทรัพยากรที่ต้องเรียกกลับมาใช้งานอีกครั้ง ไม่ใช่แค่เก็บทิ้งไว้เฉย ๆ
ท้ายที่สุด บทความตั้งคำถามให้ผู้บริหารคิดใหม่ 3 เรื่อง คือ นโยบายการเก็บรักษาข้อมูลที่สร้างจาก AI ใครเป็นคนกำหนด, การจัดซื้อสตอเรจผูกกับความต้องการฝั่งเทรนหรือสอดคล้องกับอายุข้อมูลจริง, และถ้าใช้งาน AI เพิ่มเป็นสองเท่า ค่า storage จะเพิ่มตามแบบควบคุมได้หรือไม่ ข้อสรุปคือ หากไม่วางแผนตั้งแต่วันนี้ ต้นทุนแฝงของสตอเรจอาจกลายเป็นคอขวดสำคัญของการขยาย AI ในรอบงบประมาณถัดไป