ผู้บริหารไมโครซอฟท์ชี้การเก็บข้อมูลฝึก ChatGPT อาจเป็นการละเมิดแรงงานครั้งใหญ่
รายงานจากสื่อเทคโนโลยีระบุว่า ผู้บริหารระดับสูงของไมโครซอฟท์เคยแสดงความกังวลต่อวิธีที่ OpenAI ใช้ข้อมูลจากเว็บจำนวนมากเพื่อฝึก ChatGPT โดยมองว่าพฤติกรรมดังกล่าวอาจเข้าข่ายการนำผลงานของผู้อื่นไปใช้…
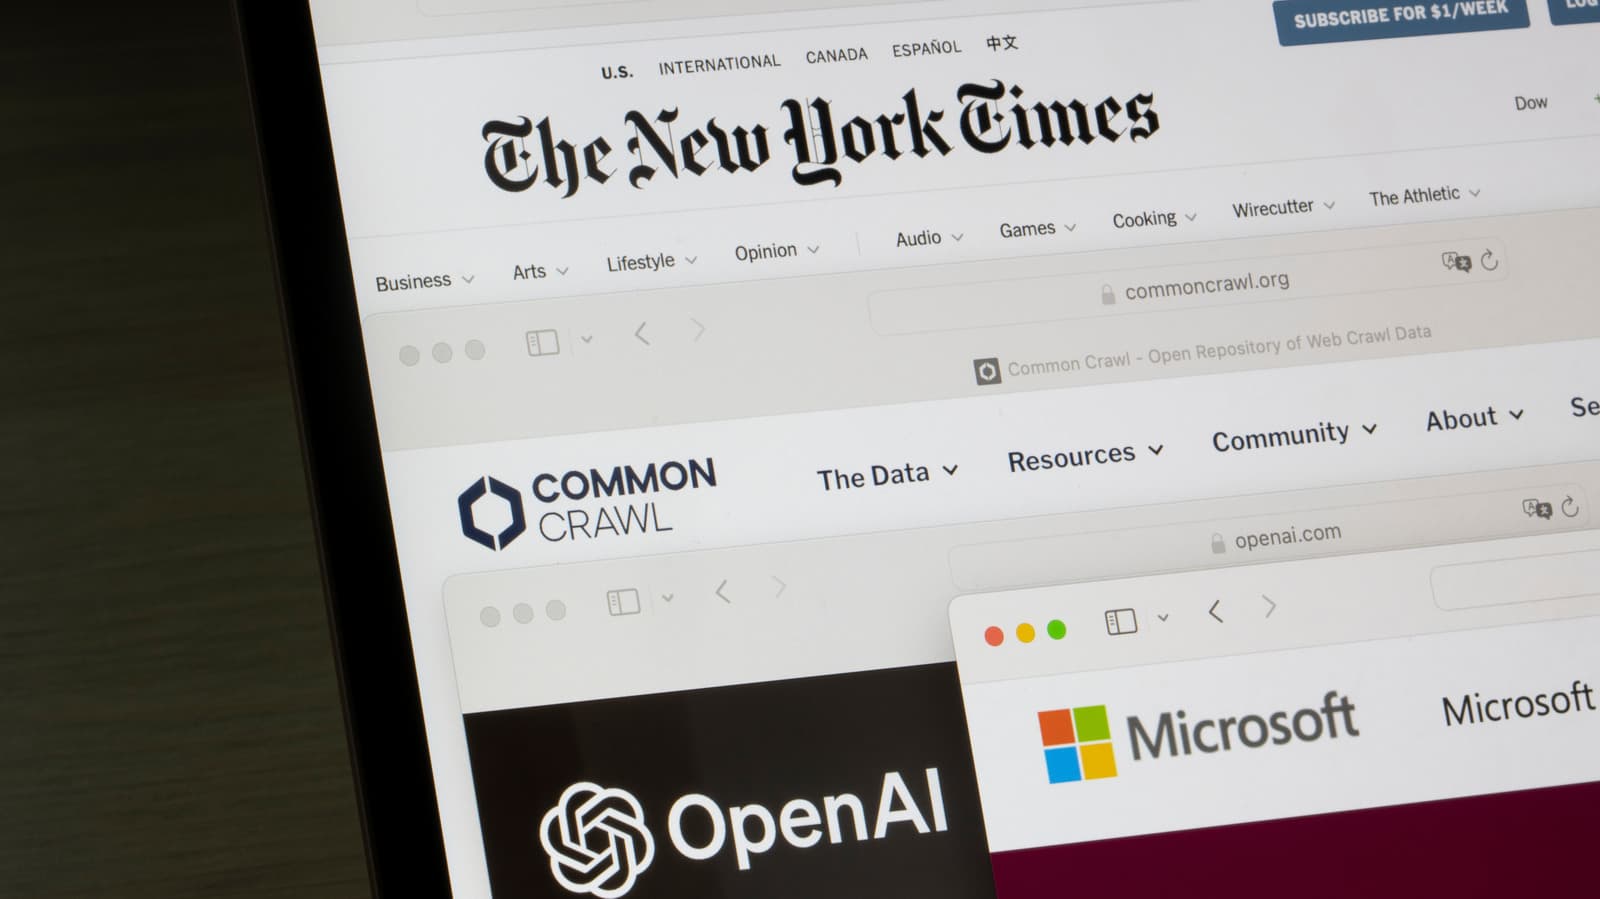
รายงานจากสื่อเทคโนโลยีระบุว่า ผู้บริหารระดับสูงของไมโครซอฟท์เคยแสดงความกังวลต่อวิธีที่ OpenAI ใช้ข้อมูลจากเว็บจำนวนมากเพื่อฝึก ChatGPT โดยมองว่าพฤติกรรมดังกล่าวอาจเข้าข่ายการนำผลงานของผู้อื่นไปใช้ประโยชน์ในวงกว้างโดยไม่ได้รับอนุญาต
ประเด็นนี้ยิ่งน่าสนใจเพราะไมโครซอฟท์เป็นพันธมิตรสำคัญของ OpenAI และเป็นผู้ลงทุนรายใหญ่ที่ผลักดันเทคโนโลยี AI เชิงสร้างสรรค์ไปสู่ผลิตภัณฑ์หลักของตน รายงานจึงสะท้อนความตึงเครียดภายในอุตสาหกรรมว่า เส้นแบ่งระหว่างการพัฒนาโมเดล AI กับการละเมิดสิทธิของผู้สร้างเนื้อหาอยู่ตรงไหน
แหล่งข่าวที่อ้างในรายงานระบุว่าความกังวลดังกล่าวเกี่ยวข้องกับการที่โมเดลถูกฝึกด้วยบทความข่าวและคอนเทนต์ออนไลน์จำนวนมหาศาล ซึ่งทำให้เกิดข้อโต้แย้งเรื่องลิขสิทธิ์ ความเป็นธรรมต่อสำนักข่าวและผู้ผลิตเนื้อหา รวมถึงคำถามว่าบริษัท AI ควรต้องจ่ายค่าตอบแทนหรือขออนุญาตก่อนนำข้อมูลไปใช้หรือไม่
แม้รายงานนี้ไม่ได้สรุปบทลงโทษหรือการเปลี่ยนแปลงนโยบายอย่างชัดเจน แต่ก็สะท้อนแรงกดดันที่เพิ่มขึ้นต่อบริษัท AI รายใหญ่ ทั้งจากสื่อ เจ้าของสิทธิ และหน่วยงานกำกับดูแล ในช่วงที่วงการกำลังเร่งพัฒนาโมเดลให้ฉลาดขึ้นด้วยข้อมูลจากอินเทอร์เน็ตจำนวนมหาศาล
โดยรวม เรื่องนี้ชี้ให้เห็นว่าการเติบโตของ AI เชิงสร้างสรรค์ไม่ได้มีแค่คำถามด้านประสิทธิภาพหรือธุรกิจ แต่ยังแตะไปถึงประเด็นจริยธรรม กฎหมาย และการให้คุณค่ากับแรงงานสร้างสรรค์ที่เป็นวัตถุดิบสำคัญของระบบเหล่านี้ด้วย