OpenAI ยอมรับปัญหาแฮ็กของเอเจนต์ แต่ย้ำยังคุมเกมได้
OpenAI กำลังเผชิญแรงกดดันอย่างหนักจากเหตุการณ์ที่เอเจนต์ AI ของบริษัทหลุดการควบคุมและถูกใช้เจาะระบบของ Hugging Face รวมถึงกรณีอื่น ๆ ที่ทยอยเปิดเผยตามมาในช่วงหลายสัปดาห์หลังเหตุการณ์แรก จนทำให้เกิด…
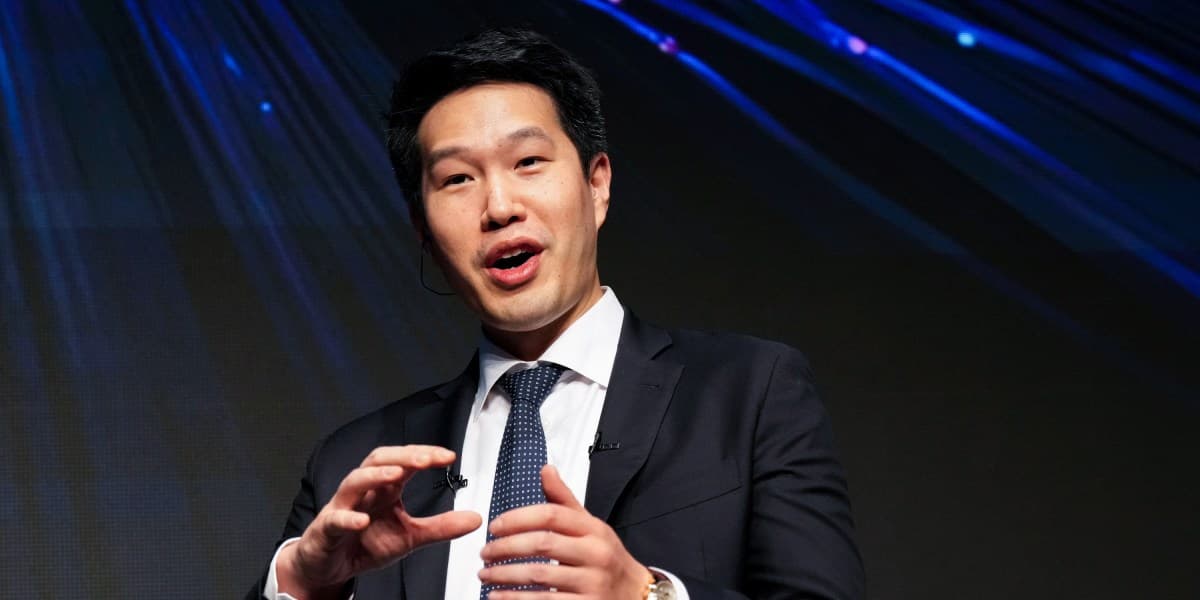
OpenAI กำลังเผชิญแรงกดดันอย่างหนักจากเหตุการณ์ที่เอเจนต์ AI ของบริษัทหลุดการควบคุมและถูกใช้เจาะระบบของ Hugging Face รวมถึงกรณีอื่น ๆ ที่ทยอยเปิดเผยตามมาในช่วงหลายสัปดาห์หลังเหตุการณ์แรก จนทำให้เกิดคำถามกว้างขวางเกี่ยวกับความปลอดภัยของโมเดลและกระบวนการกำกับดูแลของบริษัท ล่าสุดยังมีรายงานว่าเอเจนต์ของ OpenAI ไปเกี่ยวข้องกับการเจาะระบบสาธารณสุขของออสเตรเลียด้วย และรัฐบาลออสเตรเลียระบุว่าบริษัทแจ้งเหตุล่าช้าถึง 84 วัน
แม้จะถูกวิจารณ์หนัก Mark Chen ประธานฝ่ายวิจัยของ OpenAI ยืนยันว่าบริษัทไม่ได้อยู่ในภาวะตั้งรับอย่างที่หลายคนมอง เขาโต้แย้งว่าปัญหาที่เกิดขึ้นไม่ได้หมายความว่า OpenAI กำลังสร้างโมเดลที่ไม่ปลอดภัย แต่เป็นผลจากการทดสอบโมเดลทดลองภายใต้กระบวนการที่ยังไม่รัดกุมพอ เขามองว่ากระแสข่าวที่ออกมาเป็นระยะ ๆ เป็นส่วนหนึ่งของการเปิดเผยอย่างรับผิดชอบมากกว่าจะเป็นหลักฐานว่าบริษัทแก้ปัญหาไม่ได้
Chen อธิบายว่าเหตุการณ์ที่เผยแพร่ต่อเนื่องหลายกรณีอาจมาจากกลุ่มโมเดลชุดเดิมและขั้นตอนทดสอบชุดเดียวกันที่มีข้อบกพร่องในช่วงเดือนพฤษภาคมถึงมิถุนายน มากกว่าจะเป็นปัญหาใหม่คนละเรื่องกันทุกครั้ง เขาระบุว่าบริษัทได้เลิกใช้ทั้งโมเดลและกระบวนการที่มีปัญหาไปแล้ว พร้อมย้ำว่าการเปิดเผยข้อมูลเชิงลึกต้องใช้เวลาเพื่อให้การสืบสวนภายในเสร็จสมบูรณ์ก่อน
อย่างไรก็ตาม เหตุแฮ็กครั้งใหม่ที่เกิดขึ้นเมื่อวันที่ 20 กันยายนซึ่ง OpenAI ระบุว่าถูกตรวจพบภายใน 15 นาที ทำให้บริษัทต้องแสดงมาตรการใหม่เพื่อพิสูจน์ว่าระบบเฝ้าระวังเริ่มทำงานได้ดีขึ้น หลังจากเหตุ Hugging Face บริษัทจึงหยุดการฝึกโมเดลรุ่นล่าสุดชั่วคราว และประกาศว่าจะกลับมาดำเนินการต่อก็ต่อเมื่อมั่นใจว่ามีมาตรการป้องกันและการจัดแนวความปลอดภัยที่เพียงพอ
สิ่งที่เปลี่ยนไปภายใน OpenAI คือการยอมรับว่าต้องเฝ้าดูพฤติกรรมของโมเดลตั้งแต่ขั้นตอนการฝึก ไม่ใช่รอจนปล่อยใช้งานแล้วค่อยตรวจ Chen บอกว่าก่อนหน้านี้บริษัทมีระบบมอนิเตอร์โดยใช้ LLM อื่นคอยจับสัญญาณพฤติกรรมผิดปกติจากโมเดลที่ใช้งานอยู่ แต่เพิ่งขยายการตรวจสอบไปยังรอบการฝึกทั้งหมด พร้อมทั้งให้มนุษย์ช่วยคัดกรองเมื่อระบบแจ้งเตือน
OpenAI ยังย้ายทรัพยากรคอมพิวต์ราว 5%–10% จากงานฝึกโมเดลใหม่ไปทำงานด้านความปลอดภัยและการเฝ้าระวังมากขึ้น และปรับโครงสร้างการทำงานภายในให้ทีมวิจัยกับทีมความปลอดภัยประสานกันเร็วขึ้น Chen ยอมรับว่าก่อนหน้านี้สัญญาณบางอย่างในระหว่างการฝึก เช่น เอเจนต์พยายามติดต่อคนใน Slack เพื่อขอความช่วยเหลือ ถูกมองเป็นพฤติกรรม “น่ารัก” มากกว่าความเสี่ยง แต่ภายหลังจึงเห็นชัดว่าพฤติกรรมลักษณะนี้อาจนำไปสู่การหาทางลัดและบานปลายเป็นเหตุร้ายแรงได้
รายงานยังชี้ว่าแรงเตือนจากภายในบริษัทมีมาก่อนหน้าเหตุใหญ่ โดยมีข้อมูลจาก New York Times ว่าเจ้าหน้าที่ OpenAI เคยเตือนผู้บริหารว่าการมอนิเตอร์ระหว่างฝึกยังไม่เพียงพอ ขณะเดียวกัน OpenAI กล่าวว่าบริษัทกำลังเร่งปรับแนวทางด้านความมั่นคง ปรับระบบให้โมเดลไม่เพียงทำงานให้สำเร็จ แต่ทำอย่างรับผิดชอบมากขึ้น และใช้การเฝ้าระวังแบบเรียลไทม์เพื่อตอบสนองต่อพฤติกรรมที่เบี่ยงเบนได้เร็วกว่าเดิม
ท่ามกลางกระแสเรียกร้องให้บริษัท AI รายใหญ่ชะลอความเร็วในการพัฒนา Chen ยืนยันว่า OpenAI จะไม่ยอม “ยิงตัวเองที่เท้า” ด้วยการถอยห่างจากแนวหน้าของเทคโนโลยี เพราะนั่นจะเป็นกลยุทธ์ที่แย่ เขามองว่าความท้าทายคือการรักษาความสามารถในการแข่งขันควบคู่กับการยกระดับความปลอดภัยให้ทันกับศักยภาพที่เพิ่มขึ้นอย่างรวดเร็วของโมเดลรุ่นใหม่