AI-generated text ควรถูกตรวจจับได้ แต่ Apple ต้องเลี่ยงความผิดพลาดครั้งใหญ่แบบ Anthropic
บทความนี้หยิบประเด็นเรื่องการทำให้ข้อความที่สร้างโดย AI สามารถตรวจจับและระบุแหล่งที่มาได้ขึ้นมาอภิปราย โดยผู้เขียนมองว่าแนวทางนี้เป็นสิ่งที่จำเป็น เพราะปัจจุบันมีเนื้อหาที่สร้างจาก AI จำนวนมากจนกลาย…
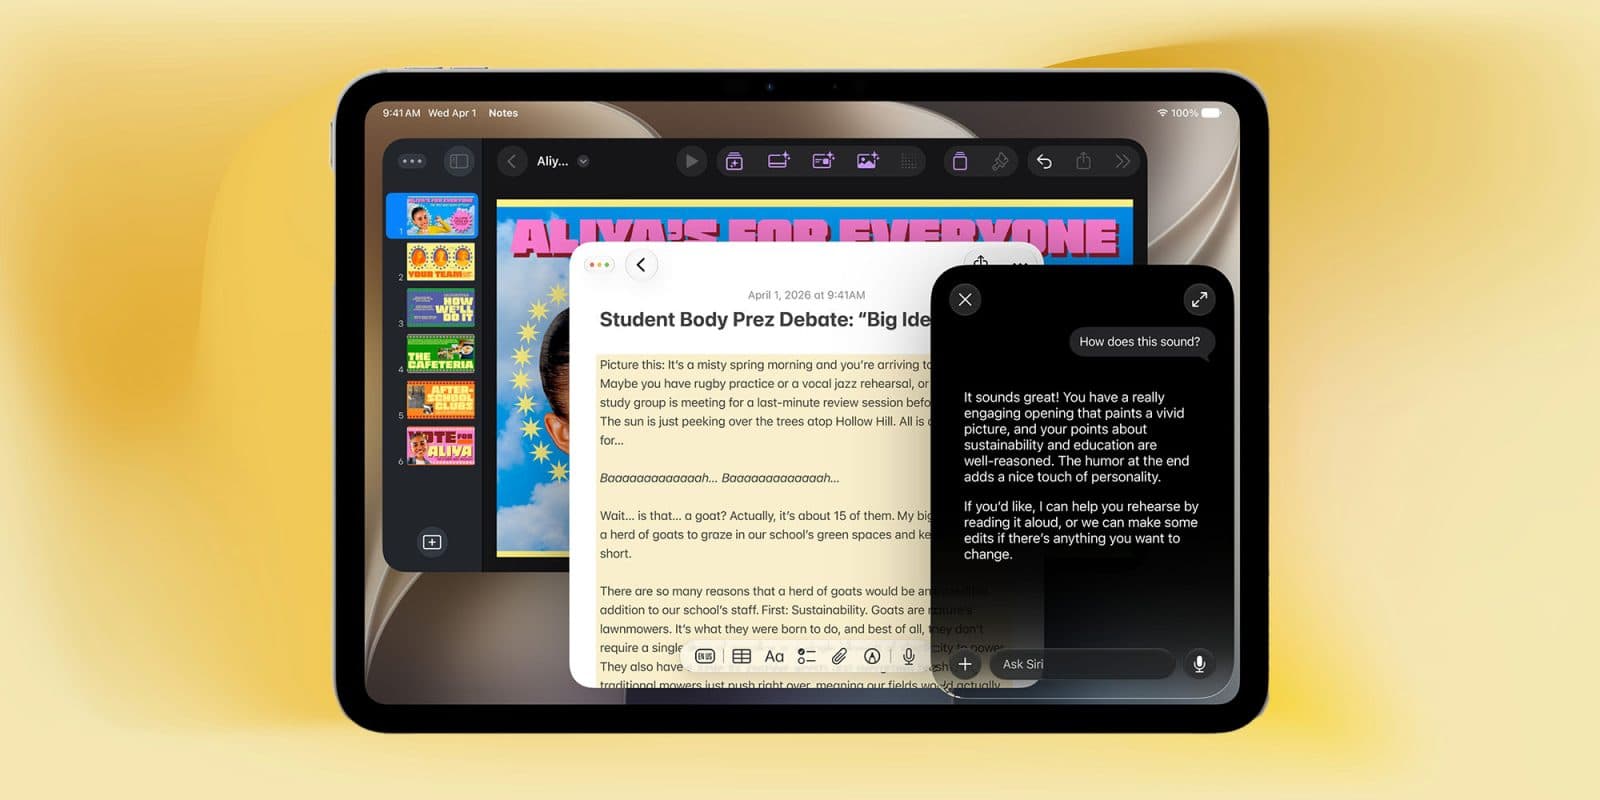
บทความนี้หยิบประเด็นเรื่องการทำให้ข้อความที่สร้างโดย AI สามารถตรวจจับและระบุแหล่งที่มาได้ขึ้นมาอภิปราย โดยผู้เขียนมองว่าแนวทางนี้เป็นสิ่งที่จำเป็น เพราะปัจจุบันมีเนื้อหาที่สร้างจาก AI จำนวนมากจนกลายเป็นภาระต่อผู้อ่าน หากมีป้ายกำกับหรือสัญลักษณ์ที่ชัดเจน ผู้ใช้ก็จะคัดกรองได้ง่ายขึ้นว่าเนื้อหาใดควรให้ความสนใจและเนื้อหาใดเป็นเพียง “AI slop” ที่ไม่จำเป็นต้องเสียเวลาตามอ่าน
อย่างไรก็ตาม ประเด็นสำคัญของชิ้นนี้ไม่ได้หยุดอยู่แค่การเห็นด้วยกับการระบุว่าเป็น AI-generated content แต่ยังตั้งคำถามต่อวิธีการที่บริษัท AI รายใหญ่เลือกใช้ในการทำ watermark หรือทำสัญลักษณ์กำกับข้อความ โดยยกตัวอย่างกรณีของ Anthropic ที่ประกาศยอมรับแนวทางของสหภาพยุโรปในการทำให้ข้อความจาก Claude ถูกทำเครื่องหมายได้ แต่ผู้เขียนเห็นว่าการดำเนินการดังกล่าวอาจออกมาในลักษณะที่ผิดพลาดและสวนทางกับเจตนารมณ์ของการตรวจจับเนื้อหา
แก่นของข้อวิจารณ์คือ การทำให้ AI text ตรวจจับได้ควรช่วยเพิ่มความโปร่งใส ไม่ใช่สร้างภาระใหม่หรือทำให้ระบบใช้งานยุ่งยากเกินจำเป็น ผู้เขียนจึงใช้กรณีของ Anthropic เป็นตัวอย่างเตือนว่า หากออกแบบ watermark หรือกลไกระบุ AI แบบไม่รอบคอบ อาจทำให้เป้าหมายด้านความชัดเจนและความน่าเชื่อถือกลายเป็นความซับซ้อนทางเทคนิคหรือประสบการณ์ใช้งานที่แย่ลงแทน
ในบริบทของ Apple บทความนี้สื่อว่าบริษัทควรเดินเกมอย่างระมัดระวัง หากจะผลักดันฟีเจอร์หรือมาตรฐานที่เกี่ยวข้องกับข้อความจาก AI เพื่อไม่ให้ซ้ำรอยความผิดพลาดของ Anthropic แนวทางที่ดีควรช่วยให้ผู้ใช้รู้ว่าข้อความไหนมาจากมนุษย์หรือ AI ได้จริง โดยไม่เปิดช่องให้เกิดการออกแบบที่ขัดกับการใช้งานหรือบั่นทอนความหมายของการติดป้ายกำกับ
โดยสรุป ชิ้นนี้สนับสนุนการมีระบบระบุข้อความจาก AI อย่างชัดเจน แต่ตั้งข้อสังเกตว่า “วิธีทำ” สำคัญพอๆ กับ “เป้าหมาย” และ Apple ควรใช้บทเรียนจากกรณีของ Anthropic เป็นอุทาหรณ์ เพื่อหลีกเลี่ยงการสร้างมาตรฐานที่ดูดีในทางทฤษฎี แต่กลับใช้งานจริงได้ไม่ดีหรือไม่สมเหตุสมผล