Hugging Face ชี้ “ผู้ประเมิน AI ในตัว” ไม่ใช่คำตอบง่ายๆ ของการวัดคุณภาพโมเดล
วงการ AI ให้ความสำคัญกับการทำ benchmark หรือการทดสอบมาตรฐานอย่างมาก เพราะผลคะแนนเหล่านี้มักถูกใช้เป็นตัวชี้ว่าระบบใด “ดีกว่า” หรือมีประสิทธิภาพเหนือคู่แข่ง แต่ Irene Solaiman ประธานเจ้าหน้าที่ฝ่าย…
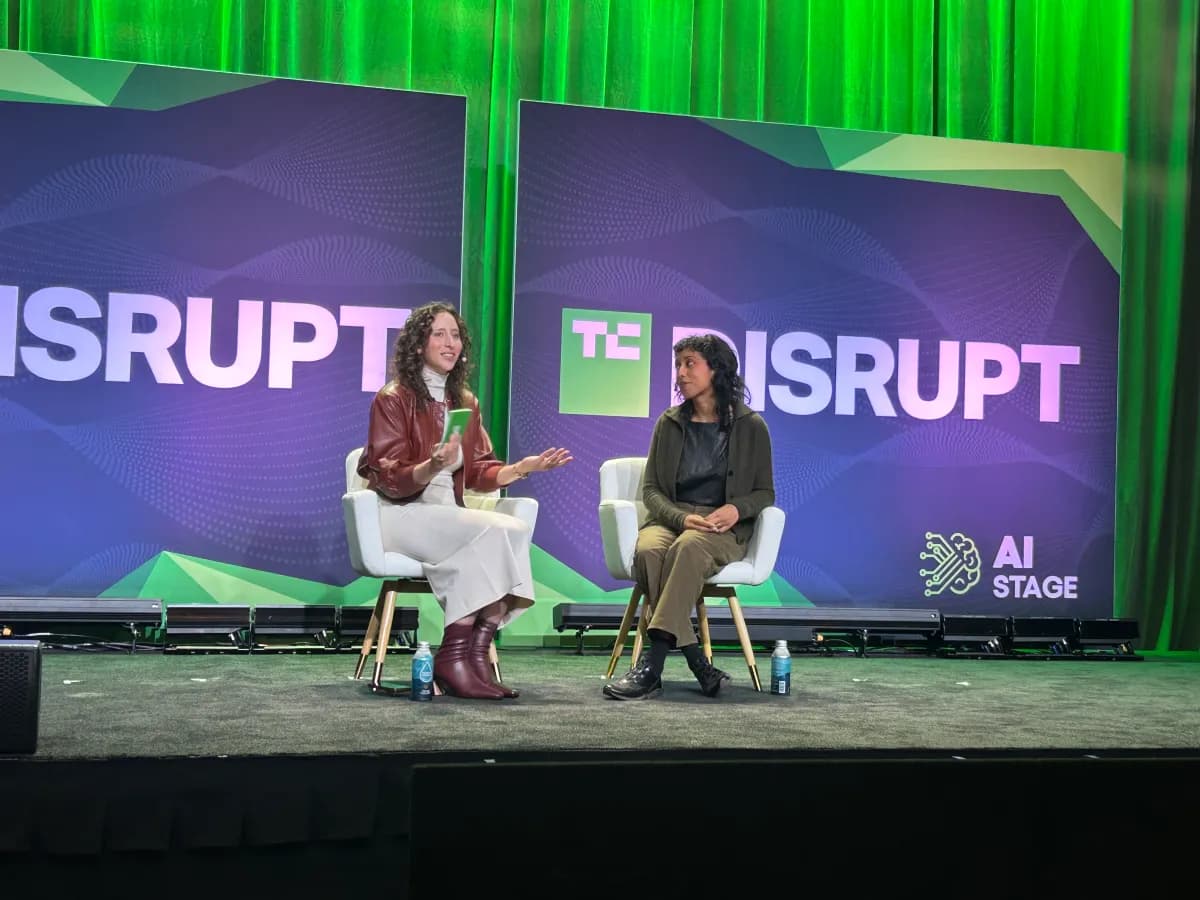
วงการ AI ให้ความสำคัญกับการทำ benchmark หรือการทดสอบมาตรฐานอย่างมาก เพราะผลคะแนนเหล่านี้มักถูกใช้เป็นตัวชี้ว่าระบบใด “ดีกว่า” หรือมีประสิทธิภาพเหนือคู่แข่ง แต่ Irene Solaiman ประธานเจ้าหน้าที่ฝ่ายนโยบายของ Hugging Face เตือนว่าเบื้องหลังการประเมินเหล่านี้ไม่ได้เรียบง่ายอย่างที่ดูภายนอก และวิธีการต่างๆ ยังอยู่ในช่วงพัฒนาอย่างต่อเนื่อง
สาระสำคัญของมุมมองนี้คือ การประเมินโมเดล AI ไม่ได้เป็นเพียงการให้คะแนนจากตัวเลขชุดเดียว แต่เกี่ยวข้องกับการออกแบบโจทย์ เงื่อนไขการทดสอบ เกณฑ์ตัดสิน และสมมติฐานจำนวนมากที่อาจส่งผลต่อผลลัพธ์ได้ ทำให้คำตอบที่ได้จาก benchmark อาจไม่สะท้อนความสามารถจริงของโมเดลในสถานการณ์ใช้งานที่หลากหลายเสมอไป
Solaiman กล่าวในเวทีสนทนาของ TechCrunch ว่าแนวคิดเรื่องการฝัง “ผู้ประเมิน AI” หรือ evaluator เข้าไปในระบบโดยตรงนั้นอาจไม่ได้เป็นทางออกที่ทำได้ง่าย เพราะแม้แต่การสร้างตัววัดที่ดูเป็นกลางก็ยังมีข้อจำกัดด้านความแม่นยำ ความสอดคล้อง และความเป็นธรรมอยู่มาก โดยเฉพาะเมื่อโมเดลสมัยใหม่มีความสามารถกว้างและพฤติกรรมซับซ้อนขึ้นเรื่อยๆ
ประเด็นนี้สะท้อนปัญหาที่กว้างกว่าการจัดอันดับโมเดลทั่วไป นั่นคืออุตสาหกรรม AI ยังต้องการมาตรฐานประเมินที่น่าเชื่อถือและตรวจสอบได้มากขึ้น เพื่อให้บริษัท นักวิจัย และผู้ใช้งานสามารถเปรียบเทียบระบบต่างๆ ได้อย่างมีความหมาย ไม่ใช่พึ่งพาคะแนนที่อาจได้รับอิทธิพลจากวิธีทดสอบหรือเป้าหมายทางการตลาดของผู้พัฒนา
ในเชิงนโยบายและการกำกับดูแล ข้อคิดเห็นของ Hugging Face ชี้ว่าการผลักดันให้ AI ปลอดภัยและรับผิดชอบมากขึ้น ไม่ได้จบที่การสร้างตัวประเมินเพิ่มขึ้นเท่านั้น แต่ต้องทำความเข้าใจข้อจำกัดของการวัดผล และออกแบบกระบวนการตรวจสอบที่โปร่งใสกว่าที่เป็นอยู่ เพื่อหลีกเลี่ยงการตีความคะแนน benchmark เกินจริง